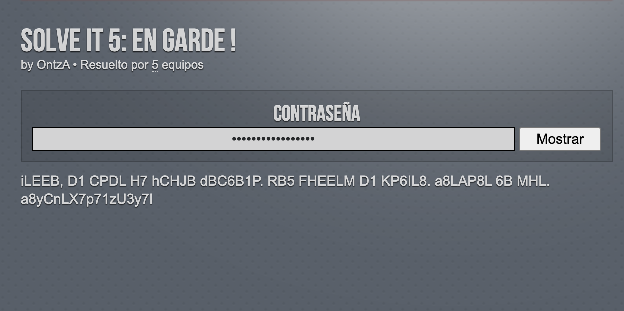
Solve It 5: En Garde! : resuelto por 5 equipos
Os dejo con el resumen de Servida, que mi cerebro está pidiendo vacaciones 🙂
Primero vimos que los espacios, puntos y comas no estaban puestos aleatoriamente, y por lo tanto, no podían formar parte del diccionario. Así que asumimos que las palabras estaban separadas correctamente y tenían que formar una frase con sentido.
Antes de seguir con decisiones correctas, hicimos un script para imprimir posibles frases descifradas, generando tablas de equivalencias aleatorias con hill climbing, dando como correctas aquellas frases cuyas k palabras (cuantas más mejor, pero asumimos que no todas las de la frase podían ser palabras que aparecieran en el diccionario) pertenecieran al diccionario de todas las palabras posibles en francés e inglés. Salieron algunas combinaciones con palabras con sentido, pero no ayudó mucho. [código después, pero de una versión mejorada]
Por la coma justo después de la primera palabra, pensamos que podía ser un saludo. Miramos posibles saludos en francés (por «en garde») pero el único que podía tener un poco de sentido («bonne») no encajaba nada, así que tiramos por los otros dos idiomas que pensábamos: inglés y español. Probando mentalmente, vimos que podría ser «Hello», y lo dimos por bueno.
Actualizamos el script para tener un diccionario de esas 4 sustituciones, y volvimos a probar. Este es el código del script (cortesIA):
import argparse
import random
import sys
from wordfreq import zipf_frequency

def parse_args():
    parser = argparse.ArgumentParser(
        description='Decifra una frase cifrada por sustitución usando hill climbing indefinidamente hasta encontrar todas las soluciones con score >= threshold.')
    parser.add_argument('-t', '--text', type=str,
                        default="iLEEB, D1 CPDL H7 hCHJB dBC6B1P. RB5 FHEELM D1 KP6IL8. a8LAP8L 6B MHL. a8yCnLX7p71zU3y7I",
                        help='Texto cifrado')
    parser.add_argument('-k', '--threshold', type=int, default=2,
                        help='Número mínimo de palabras en inglés para considerar buena una solución')
    parser.add_argument('-i', '--iterations', type=int, default=10000,
                        help='Número de intercambios por intento de hill climbing')
    parser.add_argument('-l', '--lang_threshold', type=float, default=3.0,
                        help='Frecuencia Zipf mínima para considerar una palabra perteneciente al idioma')
    return parser.parse_args()

def score_mapping(cipher, mapping, lang_thr):
    plain = ''.join(mapping.get(c, c) for c in cipher)
    count = 0
    for w in plain.split():
        w_clean = w.strip('.,;:?!"').lower()
        if w_clean:
            if zipf_frequency(w_clean, 'en') >= lang_thr:
                count += 1
    return count, plain

def random_fixed_mapping(symbols, known_map):
    remaining = [s for s in symbols if s not in known_map]
    available = [s for s in symbols if s not in known_map.values()]
    rand_mapping = known_map.copy()
    rand_mapping.update(dict(zip(remaining, random.sample(available, len(remaining)))))
    return rand_mapping

def hill_climb(cipher, symbols, known_map, lang_thr, iterations):
    # Empieza con mapping aleatorio que respeta known_map
    current_map = random_fixed_mapping(symbols, known_map)
    current_score, current_plain = score_mapping(cipher, current_map, lang_thr)

    for _ in range(iterations):
        # swap aleatorio entre símbolos no fijos
        m = current_map.copy()
        free = [s for s in symbols if s not in known_map]
        a, b = random.sample(free, 2)
        m[a], m[b] = m[b], m[a]
        sc, pl = score_mapping(cipher, m, lang_thr)
        if sc >= current_score:
            current_score, current_map, current_plain = sc, m, pl
    return current_score, current_map, current_plain

def main():
    args = parse_args()
    cipher = args.text
    threshold = args.threshold
    iterations = args.iterations
    lang_thr = args.lang_threshold

    symbols = sorted({c for c in cipher if c.isalnum()})
    # known mapping: "iLEEB" -> "Hello"
    known_map = {'i': 'H', 'L': 'e', 'E': 'l', 'B': 'o'}

    seen = set()
    attempt = 0
    print(f"Buscando soluciones con score >= {threshold} indefinidamente...")
    while True:
        attempt += 1
        score, mapping, plain = hill_climb(cipher, symbols, known_map, lang_thr, iterations)
        if score >= threshold and plain not in seen:
            seen.add(plain)
            print(f"[Solución {len(seen)} | Intento {attempt}] score={score}")
            print('Mapping:', mapping)
            print('Texto :', plain)
            print('-' * 60)

if __name__ == '__main__':
    main()
[la gracia está en subir el k, que por defecto es solo 2]
Salían más palabras reales, pero aún así no nos sirvió de mucho porque parecía casualidad; no tenían mucho sentido. Sí que llegaron a salir «killed» y «die» (a las que no dimos demasiada importancia). Aún así, lo dejamos corriendo con k=13 por si acaso encontraba algo.
Después nos dimos cuenta (con ayuda de la IA) de que sustituyendo las letras que ya teníamos, en las siguientes palabras, las 3 siguientes palabras podrían tratarse de «my name is», que también dimos por bueno. Casi inmediatamente, al tener ya «Hello, my name is» y con la cadencia de las frases (por los puntos y las comas) nos sonó muchísimo a la frase de Iñigo Montoya, y para nuestra enorme sorpresa, los caracteres encajaban perfectamente.
Antes de seguir con decisiones correctas, ignoramos la última palabra (que luego descubriríamos que sería la contraseña) y nos pusimos a mirar otras frases o mantras de la película, o incluso metiendo el número de veces que la dicen. Pero luego ya la consideramos como contraseña.
Así que a partir de aquí hicimos un diccionario:
cipher = "iLEEBD1CPDLH7hCHJBdBC6B1PRB5FHEELMD1KP6IL8a8LAP8L6BMHL"
clear  = "HellomynameisInigoMontoyaYoukilledmyfatherPreparetodie"

mapping = {}

for c, p in zip(cipher, clear):
    if c not in mapping:
        mapping[c] = p

print(mapping)
resultado:
{'i': 'H',
'L': 'e',
'E': 'l',
'B': 'o',
'D': 'm',
'1': 'y',
'C': 'n',
'P': 'a',
'H': 'i',
'7': 's',
'h': 'I',
'J': 'g',
'd': 'M',
'6': 't',
'R': 'Y',
'5': 'u',
'F': 'k',
'M': 'd',
'K': 'f',
'I': 'h',
'8': 'r',
'a': 'P',
'A': 'p'}
Este diccionario fue el que usamos para la variable `known_map`, y así el script siguió dando combinaciones, esta vez para la única palabra que faltaba. No llegamos a que nos diera una palabra que apareciera en el diccionario, pero luego vimos que tampoco la habría dado. Pero teniendo lo que teníamos hasta ahora, pudimos sustituir de la contraseña: `Pr_n_e_s_sy____sh`. Con ayuda de la IA sacamos que sería «princess as you wish» (frase que se repite mucho en la peli). Probamos «Princessasyouwish» y no era, pero claro, no podía ser, porque las letras que faltarían ya tenían su contrapartida de la clave, y ya se habrían sustituido.
Pensando (en parte) que las equivalencias serían simétricas, salió la idea de que el tercer carácter de la clave («y») correspondería a un «1» (para la «i» de «Princess»). Y aunque no son simétricas, sí nos dio la idea para probar lenguaje leet en las letras que faltaban (además de que la contraseña de otros retos también eran en leet) [¡Y por pura suerte, realmente luego vimos que «y» sí que correspondía a «1»!] Por lo tanto, para los 8 caracteres que faltaban, estas eran las opciones:
Pr_n_e_s_sy____sh
  1 c S A  Ouw1
    C   4  0UW
[la «i», «I», «s», «a» y «o» no podían ser porque ya estaban en la tabla de equivalencias»]
Así que solo tenemos 32 posibles contraseñas, que decidimos probar a mano (generándolas con 5 bucles anidados):
Pr1nceSsAsyOuw1sh
Pr1nceSsAsyOuW1sh
Pr1nceSsAsyOUw1sh
Pr1nceSsAsyOUW1sh
Pr1nceSsAsy0uw1sh
Pr1nceSsAsy0uW1sh
Pr1nceSsAsy0Uw1sh
Pr1nceSsAsy0UW1sh
Pr1nceSs4syOuw1sh
Pr1nceSs4syOuW1sh
Pr1nceSs4syOUw1sh
Pr1nceSs4syOUW1sh
Pr1nceSs4sy0uw1sh
Pr1nceSs4sy0uW1sh
Pr1nceSs4sy0Uw1sh
Pr1nceSs4sy0UW1sh
Pr1nCeSsAsyOuw1sh
Pr1nCeSsAsyOuW1sh
Pr1nCeSsAsyOUw1sh
Pr1nCeSsAsyOUW1sh
Pr1nCeSsAsy0uw1sh
Pr1nCeSsAsy0uW1sh
Pr1nCeSsAsy0Uw1sh  <--- correcta
Pr1nCeSsAsy0UW1sh
Pr1nCeSs4syOuw1sh
Pr1nCeSs4syOuW1sh
Pr1nCeSs4syOUw1sh
Pr1nCeSs4syOUW1sh
Pr1nCeSs4sy0uw1sh
Pr1nCeSs4sy0uW1sh
Pr1nCeSs4sy0Uw1sh
Pr1nCeSs4sy0UW1sh